
Τα μοντέλα τεχνητής νοημοσύνης μεταμορφώνουν τον τρόπο με τον οποίο δημιουργούμε, μοιραζόμαστε και διαφυλάσσουμε τον πολιτισμό. Ταυτόχρονα, υπάρχει ένα ζήτημα ομοιογένειας, καθώς τα μοντέλα εκπαιδεύονται κυρίως με δεδομένα στα αγγλικά και παρουσιάζουν μεροληπτικές πληροφορίες σχετικά με τις περιφερειακές πραγματικότητες. Όταν αναπτύσσονται με γνώμονα την περιεκτικότητα, τα μεγάλα γλωσσικά μοντέλα (LLM) έχουν πραγματικό δυναμικό να διευρύνουν την πρόσβαση, να διαφυλάξουν την πολιτιστική κληρονομιά, να ενισχύσουν την ποικιλόμορφη εκπροσώπηση και να εμπνεύσουν νέες μορφές δημιουργικότητας. Αυτή είναι ακριβώς η ιδέα πίσω από το Latam-GPT.
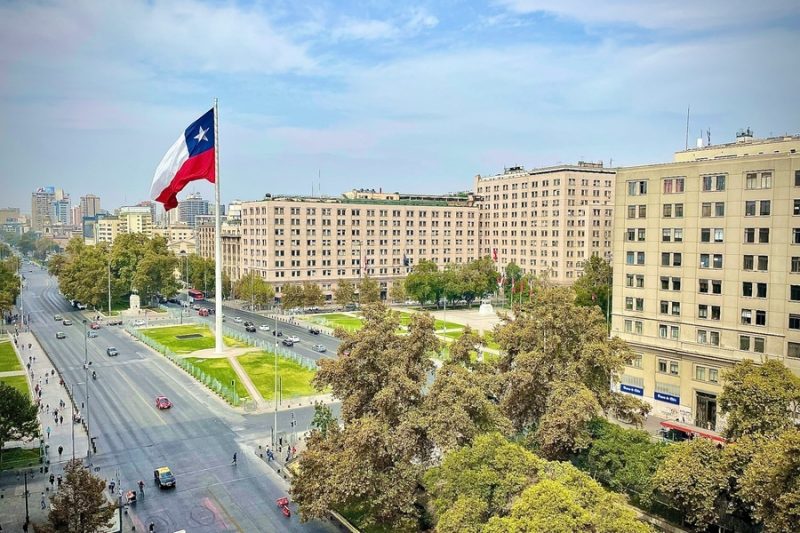
Το Latam-GPT αποτελεί το πρώτο ανοιχτού κώδικα LLM της Χιλής που έχει εκπαιδευτεί με βάση τις κουλτούρες της Λατινικής Αμερικής. Το μοντέλο τεχνητής νοημοσύνης ανακοινώθηκε για πρώτη φορά τον Φεβρουάριο του 2026 στη Σύνοδο Κορυφής για τη Δράση στην Τεχνητή Νοημοσύνη στο Παρίσι, αλλά η ανάπτυξή του ξεκίνησε περίπου το 2023, όταν μια ερευνητική ομάδα στο Εθνικό Κέντρο Τεχνητής Νοημοσύνης (CENIA) της Χιλής άρχισε να διερευνά τρόπους για την ανάπτυξη ενός LLM ειδικά προσαρμοσμένου στην περιοχή, βασισμένου σε υπάρχοντα μοντέλα τεχνητής νοημοσύνης ανοιχτού κώδικα.
Από την αρχή, η ομάδα του CENIA ήθελε να «μάθει και να δημιουργήσει μια πλατφόρμα ανοιχτού κώδικα που θα έδινε ιδιαίτερη έμφαση στις πολιτισμικές διαφορές που σχετίζονται με τη γλώσσα, αλλά και στην πολιτισμική ιστορία και τις διαφορετικές οπτικές γωνίες εντός της περιοχής της Λατινικής Αμερικής», εξηγεί η Gabriela Arriagada Bruneau, συνεργαζόμενη ερευνήτρια στο CENIA και επίκουρη καθηγήτρια στον τομέα της τεχνητής νοημοσύνης και της ηθικής των δεδομένων στο Παπικό Καθολικό Πανεπιστήμιο της Χιλής.
Η ανάγκη για μεγαλύτερη εκπροσώπηση
Το Latam-GPT δεν προτίθεται να ανταγωνιστεί το ChatGPT, το Google Gemini και παρόμοια εργαλεία για καταναλωτές. Αντίθετα, το μοντέλο στοχεύει να προσφέρει μια πιο ακριβή και αποδοτική βασική υποδομή για την περαιτέρω ανάπτυξη περιφερειακών εφαρμογών τεχνητής νοημοσύνης. Το όραμα πίσω από το μοντέλο κατέστη σαφές όταν η ομάδα του CENIA εξέτασε τα δεδομένα στα οποία βασίζονται τα δημοφιλή μοντέλα μεγάλης κλίμακας (LLM).
«Θέλαμε να δούμε ποιο ήταν το επίπεδο εκπροσώπησης, και περίπου λιγότερο από το 2% του συνόλου των δεδομένων εκπαίδευσης και των μοντέλων εκπαίδευσης που εξετάσαμε περιείχε πραγματικά δεδομένα στα ισπανικά ή στα πορτογαλικά», εξηγεί η Arriagada Bruneau.
Η ομάδα εντόπισε επίσης ζητήματα που ξεπερνούσαν την απλή αύξηση του περιεχομένου στα ισπανικά και στα πορτογαλικά. Ένα άλλο βασικό ζήτημα αφορούσε τον τρόπο με τον οποίο τα μοντέλα τεχνητής νοημοσύνης απεικονίζουν τις ιστορικές και πολιτισμικές διαφορές εντός της Λατινικής Αμερικής.
«Δεν αφορούσε απλώς την επεξεργασία της γλώσσας, αλλά και πιο βαθιά ζητήματα», λέει. «Πώς πρέπει ένα μοντέλο να αναφέρεται στις ιστορικές διαφορές; Γνωρίζουμε ότι ο τρόπος με τον οποίο εκπαιδεύεις το μοντέλο και ο τρόπος με τον οποίο εφαρμόζεις οποιουδήποτε είδους φιλτράρισμα ή κριτήρια αξιολόγησης θα επηρεάσει τον τρόπο με τον οποίο το αποτέλεσμα θα αναπαριστά αυτά τα ζητήματα».
Για την αποτελεσματική αντιμετώπιση αυτών των ζητημάτων, το έργο βασίζεται σε μεγάλο βαθμό στη συνεργασία. Το CENIA συνεργάζεται με εταίρους από περισσότερες από 20 χώρες της Λατινικής Αμερικής, μεταξύ των οποίων ακαδημαϊκά και κυβερνητικά ιδρύματα, μη κερδοσκοπικοί οργανισμοί και τοπικές κοινότητες.
Η συμμετοχή των τοπικών κοινοτήτων στην αξιολόγηση του μοντέλου
Η συνεργατική προσέγγιση του Latam-GPT διαμορφώνει επίσης τον τρόπο αξιολόγησης του μοντέλου. Αναπτύσσοντας τα δικά της δοκιμαστικά πρότυπα, η ομάδα μπορεί να ελέγξει σε ποιο βαθμό τα γλωσσικά μοντέλα κατανοούν με ακρίβεια τις περιφερειακές γνώσεις.
«Δημιουργήσαμε δοκιμαστικά πρότυπα και πιστεύω ότι αυτός ήταν ένας πολύ όμορφος τρόπος μάθησης», λέει η Arriagada Bruneau. «Αποδείχθηκε μια πολύ ωραία αποδοχή από την κοινότητα του τρόπου με τον οποίο αντιλαμβανόμαστε τα γλωσσικά μοντέλα.»
Ένα από αυτά είναι το Choclo, ένα ανοιχτού κώδικα πρότυπο αξιολόγησης που επικεντρώνεται στις πολιτισμικές γνώσεις της Λατινικής Αμερικής. Το Choclo έχει ως στόχο να αποτυπώσει τον πλούτο, την ποικιλομορφία και την ιδιαιτερότητα των πολιτισμικών γνώσεων της Λατινικής Αμερικής. Περιλαμβάνει πάνω από 100.000 σειρές ερωτήσεων που καλύπτουν θέματα όπως η γεωγραφία, η πανίδα, η χλωρίδα, οι παραδόσεις, η γαστρονομία και τα δημόσια πρόσωπα. Αυτή η προσέγγιση δεν αφορά μόνο τη γενική γνώση που τα LLM αποκτούν συνήθως από το διαδίκτυο, αλλά και την εμπλοκή των ανθρώπων στην παροχή αυτής της γνώσης.
Εκτός από το Choclo, η ομάδα ανέπτυξε επίσης το ανοιχτού κώδικα benchmark Trueque, το οποίο αποτελείται από 500 επιλεγμένες ερωτήσεις για τη δοκιμή της πραγματικής γνώσης και της πολιτισμικής καταλληλότητας. Για την περαιτέρω εκπαίδευση του Latam-GPT, δημιουργήθηκε η πειραματική διαδραστική πλατφόρμα συνομιλίας Copuchat με σκοπό την εκπαίδευση του μοντέλου.
Διαφάνεια και δεοντολογία στην ανάπτυξη της τεχνητής νοημοσύνης
Όπως εξηγεί η Arriagada Bruneau, η διαφάνεια αποτελεί κεντρικό στοιχείο του έργου, το οποίο περιλαμβάνει τόσο ανοιχτό λογισμικό όσο και ανοιχτά βάρη. Η ομάδα εστιάζει επίσης σε ζητήματα που αφορούν τη διαχείριση δεδομένων και την ηθική της τεχνητής νοημοσύνης, όπως η διαφάνεια, η προστασία της ιδιωτικής ζωής, η μεροληψία και η γλωσσική πολυμορφία.
«Υπάρχουν αυτά που θα αποκαλούσα “παραδοσιακές ηθικές αρχές” – διαφάνεια, ευθύνη, δικαιοσύνη, λογοδοσία για τη μεροληψία», λέει. «Αλλά εξετάσαμε επίσης, για παράδειγμα, κριτήρια για τη γλωσσική ποικιλομορφία».
Η ομάδα του CENIA έχει επίσης αναπτύξει, σε συνεργασία με την ομάδα GobLab UAI, ένα δελτίο διαφάνειας που περιγράφει λεπτομερώς τη λογική πίσω από τις παρεμβάσεις στα δεδομένα του έργου και τα επίπεδα προστασίας της ιδιωτικής ζωής που τηρούνται. Λόγω της περιορισμένης νομοθεσίας για την τεχνητή νοημοσύνη στη Χιλή, μεγάλο μέρος του πλαισίου υπεύθυνης τεχνητής νοημοσύνης του έργου βασίζεται στη δική της δέσμευση της ομάδας για διαφάνεια και ηθική της τεχνητής νοημοσύνης.
Η επόμενη φάση: ενίσχυση των δυνατοτήτων και διεύρυνση των συνεργασιών
Καθώς το έργο εισέρχεται στη δεύτερη φάση του, η έμφαση δίνεται στην ενίσχυση των ικανοτήτων συλλογισμού και επίλυσης προβλημάτων του Latam-GPT, καθώς και στην επέκταση της εκπαίδευσης με βάση το συγκείμενο. Το CENIA συνεργάζεται επίσης με ανθρωπολόγους, κοινωνιολόγους και εκπροσώπους συμβουλευτικών υπηρεσιών από διάφορες αυτόχθονες κοινότητες, προκειμένου να διερευνήσει τις δυνατότητες ενσωμάτωσης αυτόχθονων γλωσσών και γνώσεων.
Για την περαιτέρω ενίσχυση της περιφερειακής συνεργασίας, η ομάδα δημιουργεί μια στρατηγική συμμαχία με τη Βραζιλία. Τέτοιου είδους συνεργασίες επιτρέπουν στο έργο να επεκτείνει τις τεχνικές του δυνατότητες, αλλά συμβάλλουν επίσης στην αμφισβήτηση της παραδοχής ότι η ανάπτυξη της τεχνητής νοημοσύνης πρέπει να ακολουθεί μια προκαθορισμένη πορεία.
Αυτό μπορεί τελικά να αποτελέσει μία από τις σημαντικότερες συνεισφορές του Latam-GPT. Το έργο απομακρύνεται από την απλή προσθήκη περισσότερων δεδομένων από τη Λατινική Αμερική στα μοντέλα τεχνητής νοημοσύνης και εστιάζει αντ’ αυτού στη διερεύνηση του τι σημαίνει πραγματικά η ανάπτυξη ενός μοντέλου εντός της περιοχής: «υπάρχουν διαφορετικοί τρόποι με τους οποίους μπορούμε να κάνουμε τη τεχνολογία δική μας, ώστε να εξυπηρετεί τις ανάγκες και τα πλαίσια διαφορετικών ανθρώπων».