
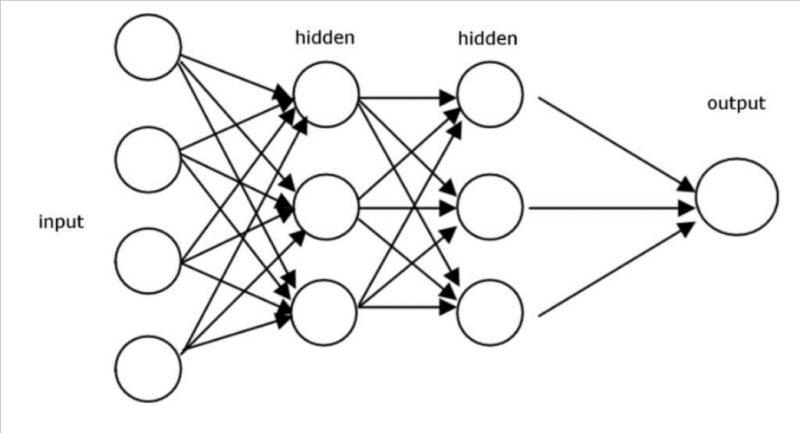
Από τη γραμμική άλγεβρα και τη στατιστική έως τους μετασχηματιστές και τις GPU, μια περιήγηση στις μαθηματικές αρχές της σύγχρονης Τεχνητής Νοημοσύνης.
Η γλώσσα ως μαθηματικό πρόβλημα
Πώς μπορεί μια μηχανή να γράφει κείμενα, να μεταφράζει, να προγραμματίζει και να απαντά σε επιστημονικά ερωτήματα; Η απάντηση δεν βρίσκεται σε κάποιον μυστηριώδη μηχανισμό τεχνητής σκέψης. Βρίσκεται στον συνδυασμό μαθηματικών μεθόδων που αναπτύχθηκαν επί δεκαετίες: γραμμικής άλγεβρας, θεωρίας πιθανοτήτων, διαφορικού λογισμού, αριθμητικής βελτιστοποίησης και θεωρίας πληροφορίας.
Τα μεγάλα γλωσσικά μοντέλα (Large Language Models, LLMs) εκπαιδεύονται ώστε να εκτιμούν ποιο είναι το πιθανότερο επόμενο τμήμα κειμένου, λαμβάνοντας υπόψη όσα έχουν προηγηθεί. Αυτή η φαινομενικά απλή διαδικασία, όταν πραγματοποιείται σε τεράστια κλίμακα, οδηγεί στην εκμάθηση σύνθετων γλωσσικών, εννοιολογικών και στατιστικών σχέσεων.
Η βασική αρχή μπορεί να εκφραστεί ως:
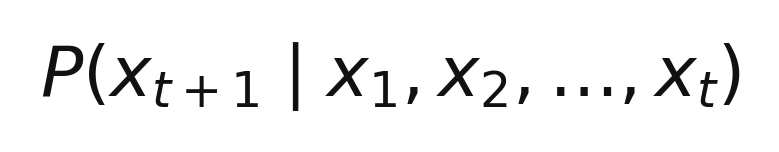
Το μοντέλο υπολογίζει μια κατανομή πιθανοτήτων για το επόμενο στοιχείο της ακολουθίας. Δεν αναζητά απλώς την επόμενη λέξη σε ένα λεξικό. Υπολογίζει πιθανότητες για μικρότερες ή μεγαλύτερες μονάδες κειμένου, που ονομάζονται tokens.
Από τις λέξεις στα διανύσματα
Ο υπολογιστής δεν επεξεργάζεται απευθείας τις έννοιες των λέξεων. Κάθε στοιχείο κειμένου αντιστοιχίζεται αρχικά σε έναν αριθμητικό κωδικό και στη συνέχεια σε ένα διάνυσμα, δηλαδή σε μια ακολουθία πραγματικών αριθμών.
Για παράδειγμα, η λέξη «επιστήμη» μπορεί να αναπαρίσταται από ένα διάνυσμα εκατοντάδων ή χιλιάδων διαστάσεων. Οι τιμές του δεν αντιστοιχούν υποχρεωτικά σε ανθρώπινα αναγνωρίσιμες έννοιες. Προκύπτουν κατά την εκπαίδευση, ώστε να διευκολύνουν την πρόβλεψη και την επεξεργασία της γλώσσας.
Η ομοιότητα δύο διανυσμάτων μπορεί να μετρηθεί με τη συνημιτονική ομοιότητα:
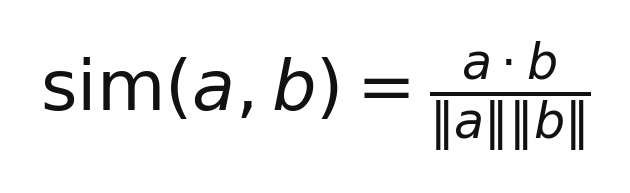
Όσο μεγαλύτερη είναι η τιμή, τόσο περισσότερο ευθυγραμμίζονται τα διανύσματα. Η μέθοδος χρησιμοποιείται ευρέως στην αναζήτηση σημασιολογικά συναφών κειμένων, αν και η πραγματική επεξεργασία των LLMs είναι πολύ πιο σύνθετη.
Έτσι, η γλώσσα μετατρέπεται σε ένα μαθηματικό περιβάλλον όπου οι σχέσεις μπορούν να εκφραστούν μέσω πράξεων μεταξύ διανυσμάτων και πινάκων.
Ο μηχανισμός προσοχής: Πώς συνδέονται οι λέξεις
Η σημαντικότερη αρχιτεκτονική καινοτομία των σύγχρονων LLMs είναι ο μετασχηματιστής (Transformer), που παρουσιάστηκε το 2017.
Ο βασικός μηχανισμός του είναι η αυτοπροσοχή (self-attention). Επιτρέπει σε κάθε στοιχείο του κειμένου να αξιοποιεί πληροφορίες από άλλα στοιχεία της ακολουθίας, ανάλογα με τη συνάφειά τους.
Στη φράση «Η ερευνήτρια δημοσίευσε τη μελέτη της επειδή είχε ολοκληρώσει την ανάλυση», το μοντέλο πρέπει να αναγνωρίσει τις σχέσεις ανάμεσα στην ερευνήτρια, τη μελέτη και την ανάλυση.
Αυτό πραγματοποιείται με τρεις μαθηματικές αναπαραστάσεις: ερώτημα (Query), κλειδί (Key) και τιμή (Value).
Ο βασικός τύπος είναι:
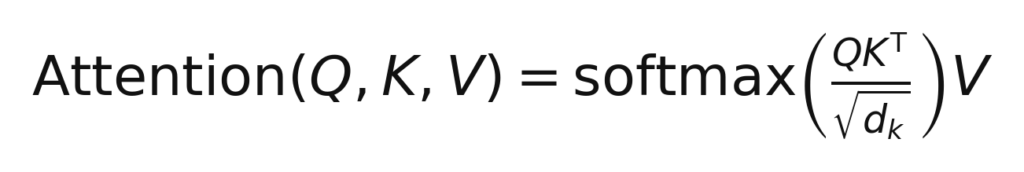
Ο πολλαπλασιασμός των πινάκων υπολογίζει βαθμούς συνάφειας. Η διαίρεση με την τετραγωνική ρίζα της διάστασης περιορίζει την αριθμητική κλίμακα των αποτελεσμάτων. Η συνάρτηση softmax μετατρέπει αυτούς τους βαθμούς σε βάρη που αθροίζονται στη μονάδα.
Στα μοντέλα παραγωγής κειμένου εφαρμόζεται επίσης περιορισμός, ώστε κάθε θέση να μην αξιοποιεί μελλοντικά στοιχεία της ακολουθίας.
Ο μηχανισμός δεν αποδεικνύει ότι η μηχανή κατανοεί τη γλώσσα όπως ο άνθρωπος. Δείχνει όμως πώς μπορεί να μαθαίνει και να αξιοποιεί σύνθετες σχέσεις μέσα στο κείμενο.
Πώς μαθαίνει ένα μοντέλο: Σφάλμα και παράγωγοι
Κατά την εκπαίδευση, το μοντέλο παράγει πιθανότητες και συγκρίνει τις προβλέψεις του με τα πραγματικά στοιχεία του εκπαιδευτικού κειμένου.
Μια συνηθισμένη συνάρτηση απώλειας είναι η διασταυρούμενη εντροπία:
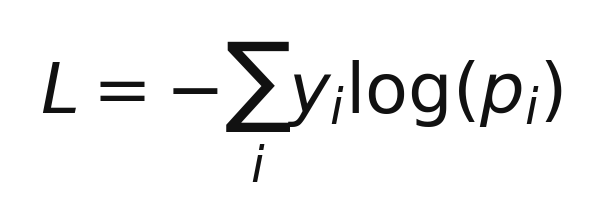
Εδώ, yᵢ είναι η πραγματική κατανομή και pᵢ η προβλεπόμενη. Όταν η σωστή απάντηση έχει μικρή πιθανότητα, η απώλεια αυξάνεται.
Το μοντέλο προσπαθεί να ελαχιστοποιήσει αυτή την ποσότητα, τροποποιώντας τις παραμέτρους του.
Η θεμελιώδης ιδέα της καθόδου κλίσης περιγράφεται ως:
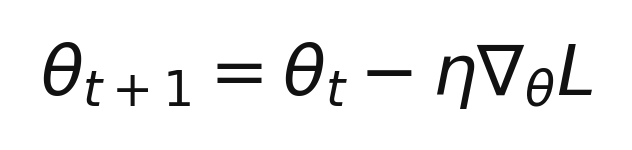
Οι παράμετροι μεταβάλλονται προς την κατεύθυνση που μειώνει το σφάλμα, με ρυθμό που εξαρτάται από το βήμα μάθησης.
Στην πράξη χρησιμοποιούνται πιο σύνθετοι αλγόριθμοι, όπως ο AdamW. Οι απαραίτητες παράγωγοι υπολογίζονται με οπισθοδιάδοση του σφάλματος, εφαρμόζοντας επανειλημμένα τον κανόνα της αλυσίδας.
Η εκπαίδευση ενός LLM είναι επομένως μια τεράστια διαδικασία αριθμητικής βελτιστοποίησης, όχι χειροκίνητη εισαγωγή κανόνων γραμματικής ή γνώσεων.
Γιατί απαιτούνται τόσο ισχυροί υπολογιστές
Το μεγαλύτερο μέρος των υπολογισμών ενός LLM αποτελείται από πολλαπλασιασμούς πινάκων. Αυτές οι πράξεις μπορούν να εκτελούνται παράλληλα, γεγονός που εξηγεί τη σημασία των επεξεργαστών γραφικών (GPU).
Οι εξειδικευμένες μονάδες Tensor Cores επιταχύνουν τις πράξεις πινάκων, συχνά χρησιμοποιώντας αριθμητικές αναπαραστάσεις μειωμένης ακρίβειας.
Ωστόσο, η ταχύτητα δεν εξαρτάται μόνο από την υπολογιστική ισχύ. Εξαρτάται επίσης από το πόσο γρήγορα μεταφέρονται δεδομένα μεταξύ μνήμης και επεξεργαστή.
Ο κλασικός μηχανισμός αυτοπροσοχής απαιτεί υπολογισμούς που αυξάνονται τετραγωνικά με το μήκος της ακολουθίας, όταν υπολογίζονται οι συσχετίσεις όλων των θέσεων.
Γι’ αυτό αναπτύχθηκαν τεχνικές όπως το FlashAttention, που μειώνει τις μεταφορές δεδομένων και τη χρήση ενδιάμεσης μνήμης, χωρίς να αντικαθιστά τον βασικό μαθηματικό ορισμό της ακριβούς προσοχής.
Κατά την παραγωγή κειμένου, η προσωρινή αποθήκευση προηγούμενων κλειδιών και τιμών, γνωστή ως KV cache, αποφεύγει περιττούς επανυπολογισμούς. Τεχνικές όπως το Grouped-Query Attention μειώνουν περαιτέρω τις ανάγκες μνήμης.
Τι μπορούν και τι δεν μπορούν να εξηγήσουν τα μαθηματικά
Η μαθηματική περιγραφή εξηγεί πώς ένα μοντέλο υπολογίζει πιθανότητες, μαθαίνει παραμέτρους και παράγει απαντήσεις. Δεν εξηγεί ακόμη πλήρως πώς αναδύονται όλες οι ικανότητές του.
Η παραγωγή πειστικού κειμένου δεν εγγυάται πραγματολογική ορθότητα. Ένα μοντέλο μπορεί να παράγει μια στατιστικά εύλογη αλλά λανθασμένη απάντηση, επειδή η πιθανότητα μιας ακολουθίας δεν ταυτίζεται με την αλήθεια της.
Αυτό έχει ιδιαίτερη σημασία για την επιστημονική έρευνα. Η αξιολόγηση πρέπει να εξετάζει όχι μόνο τη γλωσσική ποιότητα, αλλά και την ακρίβεια, την τεκμηρίωση, την αναπαραγωγιμότητα και την αβεβαιότητα.
Τα ανοιχτά μοντέλα, ιδίως εκείνα που δημοσιεύουν κώδικα, βάρη, δεδομένα και πληροφορίες εκπαίδευσης, επιτρέπουν στους ερευνητές να εξετάζουν τις μαθηματικές υποθέσεις, να αναπαράγουν πειράματα και να εντοπίζουν περιορισμούς.
Από τη μαθηματική γνώση στην ανοιχτή επιστήμη
Για έναν επιστήμονα που δεν ειδικεύεται στην Τεχνητή Νοημοσύνη, δεν είναι απαραίτητο να γνωρίζει κάθε λεπτομέρεια της αρχιτεκτονικής ενός LLM. Είναι όμως χρήσιμο να κατανοεί πέντε θεμελιώδεις έννοιες: διανύσματα, πολλαπλασιασμό πινάκων, πιθανότητες, παραγώγους και αριθμητική βελτιστοποίηση.
Αυτές αποτελούν τη βάση πάνω στην οποία στηρίζονται οι σύγχρονες τεχνικές, από την αυτοπροσοχή έως την εκπαίδευση και την αποδοτική εκτέλεση.
Η κατανόησή τους επιτρέπει στους ερευνητές να αξιολογούν καλύτερα τις δυνατότητες και τους περιορισμούς της ΤΝ, αντί να αντιμετωπίζουν τα γλωσσικά μοντέλα ως ανεξήγητα τεχνολογικά συστήματα.
Το σημαντικότερο συμπέρασμα είναι ότι η επιστημονική πρόοδος στην ΤΝ δεν απαιτεί μόνο μεγαλύτερα μοντέλα και ισχυρότερους υπολογιστές. Απαιτεί ανοιχτές μεθόδους, επαληθεύσιμα αποτελέσματα και πρόσβαση στη γνώση που καθιστά δυνατή την ανεξάρτητη έρευνα.